

Hello les masters Fabric !
OneLake, dans Microsoft Fabric, a une promesse simple : centraliser toutes vos sources de données, en Zéro-Copy, dans un seul lac gouverné. On me pose souvent les mêmes questions :
Pourquoi mes coûts de stockage augmentent-ils mois après mois, sans qu’aucun nouveau volume ne soit ingéré ?
Ce storage peut-il être optimisé ?
Comment savoir combien de fichiers Parquet composent chacune de mes tables, et par où commencer l’optimisation ?
Aujourd’hui, on décortique un problème de maintenance des table delta sur Microsoft Fabric.
⚡ En 30 secondes
Ce qu’il faut retenir :
La maintenance d’une table Delta Lake sur Fabric repose sur 4 commandes :
OPTIMIZE(compaction bin-packing),V-Order(optimisation d’écriture Fabric-native),Z-Order(data-skipping sélectif) etVACUUM(nettoyage du storage OneLake).Vous pouvez lancer cette maintenance en 3 clics depuis l’UI Lakehouse ou l’orchestrer via une Lakehouse Maintenance activity (Preview) dans un Pipeline Data Factory.
La règle terrain :
OPTIMIZEaprès une ingestion massive,VACUUMchaque semaine,V-Orderuniquement sur les tables consommées par Power BI Direct Lake ou Warehouse. RétentionVACUUMpar défaut : 7 jours, ne descendez pas en dessous sans savoir pourquoi.
Chaque jour, sans que vous le voyiez, des petits fichiers s’accumulent au fil des ingestions. D’autres fichiers Parquet, qui ne sont plus référencés par la table active, restent physiquement présents sur OneLake parce que personne n’a jamais passé de VACUUM. C’est la mécanique du format Delta Lake : chaque modification (INSERT, UPDATE, DELETE, MERGE) est tracée par le journal de transactions _delta_log, qui référence la version active de la table et permet le time travel, revenir à un instant T de la donnée. Cette garantie a un coût : sans nettoyage explicite, votre Lakehouse continue de payer pour des fichiers historiques dont plus aucun rapport ne se sert.
La réalité du terrain, c’est que Microsoft Fabric ne fait pas la maintenance à votre place. Le format Delta est natif, mais la maintenance de vos tables reste à votre charge. Fabric vous donne les outils pour économiser du temps, du compute (CU) et du storage OneLake, à condition de les utiliser.
Quatre commandes composent cette boîte à outils : OPTIMIZE, V-Order, Z-Order, VACUUM. Chacune a un usage précis. En confondre une avec une autre, c’est l’erreur classique sur le terrain.
Aujourd’hui, on pose les fondations.
Les 4 leviers de maintenance Delta Lake sur Fabric
Delta Lake est le format de stockage natif de OneLake. Chaque table est un dossier de fichiers Parquet, gouverné par un journal de transactions (_delta_log). Avec le temps, ce dossier accumule des petits fichiers, des versions historiques, et de la fragmentation. La maintenance sert à garder cette couche physique compacte, indexée et propre.
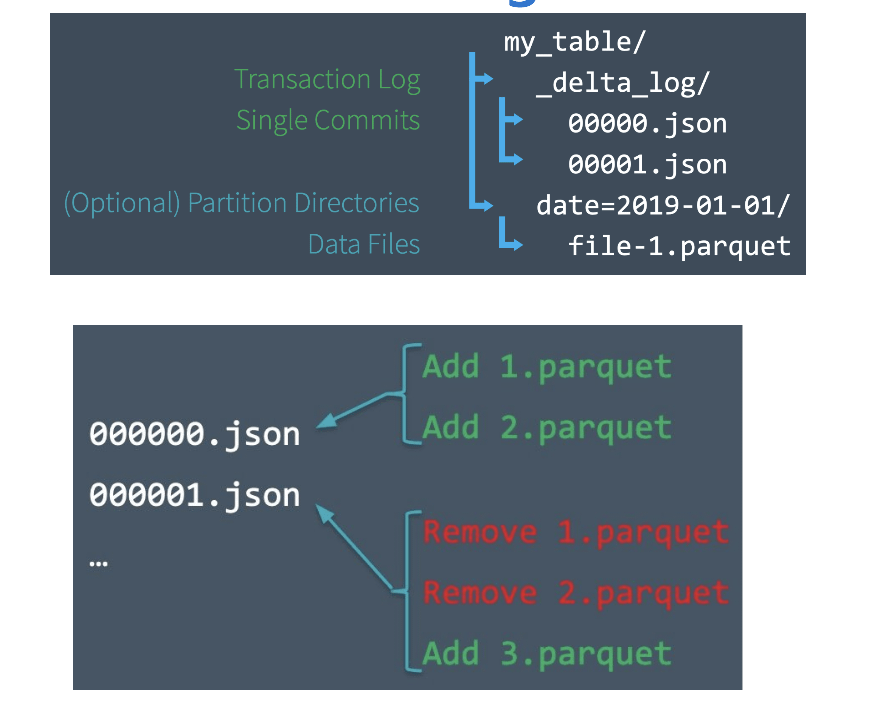
Quatre leviers :
OPTIMIZE, compaction (bin-packing) : réécrit les petits fichiers Parquet en fichiers plus gros pour réduire l’overhead de scan à chaque lecture.V-Order(VORDER), optimisation d’écriture Fabric-native : réorganise les Parquet (row-group distribution, encoding, compression) pour améliorer la lecture, en particulier sur Power BI Direct Lake et Warehouse.Z-ORDER BY, data-skipping sélectif : co-localise les lignes qui partagent des valeurs proches sur 2 à N colonnes, pour que le moteur saute des fichiers entiers lors d’un filtre. Optionnel.VACUUM, nettoyage du stockage: supprime physiquement les fichiers Parquet qui ne sont plus référencés par le Delta log et qui sont plus vieux que la rétention (7 jours par défaut).
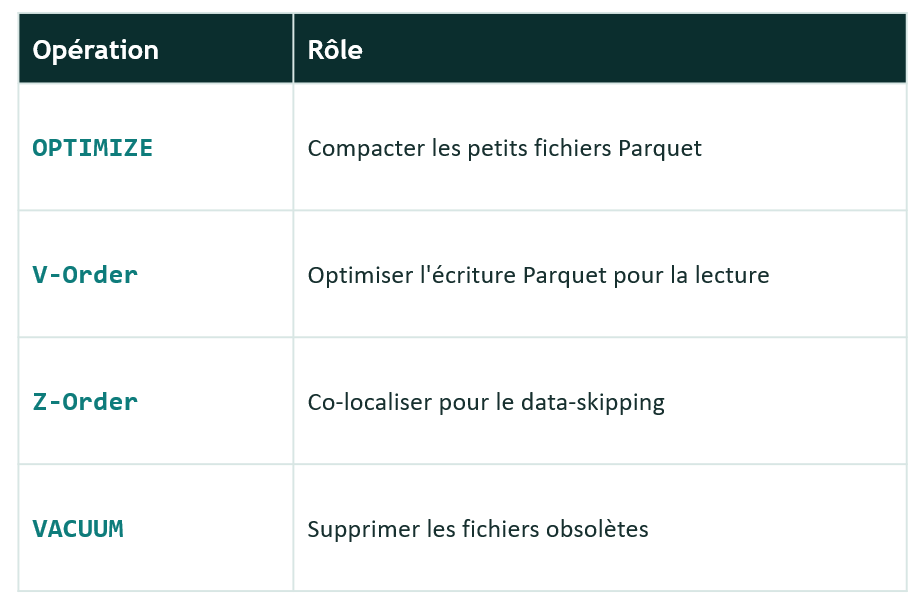
Cette maintenance est particulièrement critique si votre Lakehouse alimente la couche Gold de votre architecture Médaillon Bronze / Silver / Gold sur Microsoft Fabric, la santé de vos fichiers Parquet détermine la performance perçue par vos utilisateurs métier.
Maintenance sur l’interface utilisateur du Lakehouse
Pour débuter, Fabric expose une action de maintenance directement depuis l’explorateur Lakehouse. C’est le chemin le plus court pour lancer une maintenance ponctuelle sur une table.
Ouvrez votre Lakehouse dans le portail Fabric.
Dans Lakehouse Explorer, sous Tables, faites un clic droit sur la table cible (ou utilisez l’ellipsis).
Sélectionnez l’entrée de menu Maintenance.
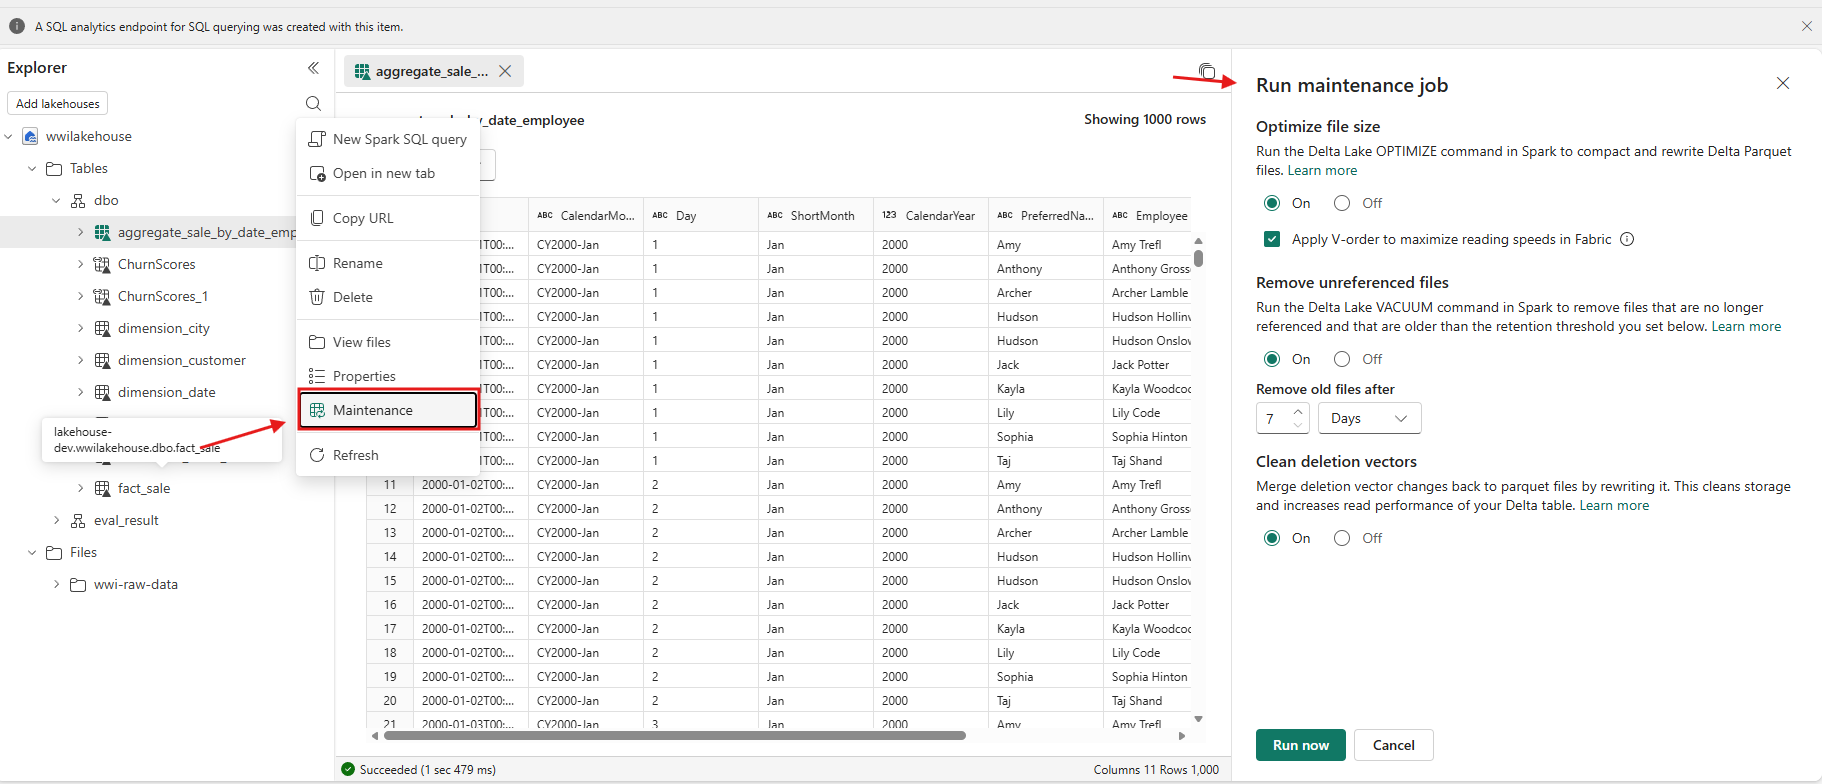
Dans la boîte de dialogue “Run maintenance commands”, cochez ce que vous voulez lancer :
Optimize (On) : compacte les petits fichiers Parquet en fichiers plus gros.
Apply V-Order (case à cocher, disponible si Optimize est On) : applique V-Order pendant la compaction. La doc Microsoft cite un impact d’environ 15 % sur le temps d’écriture, avec jusqu’à 50 % de compression supplémentaire.
Vacuum (On) : supprime les fichiers non référencés plus vieux que la rétention.
Retention threshold (heures) : 168 heures (7 jours) par défaut.
Cliquez sur Run now.
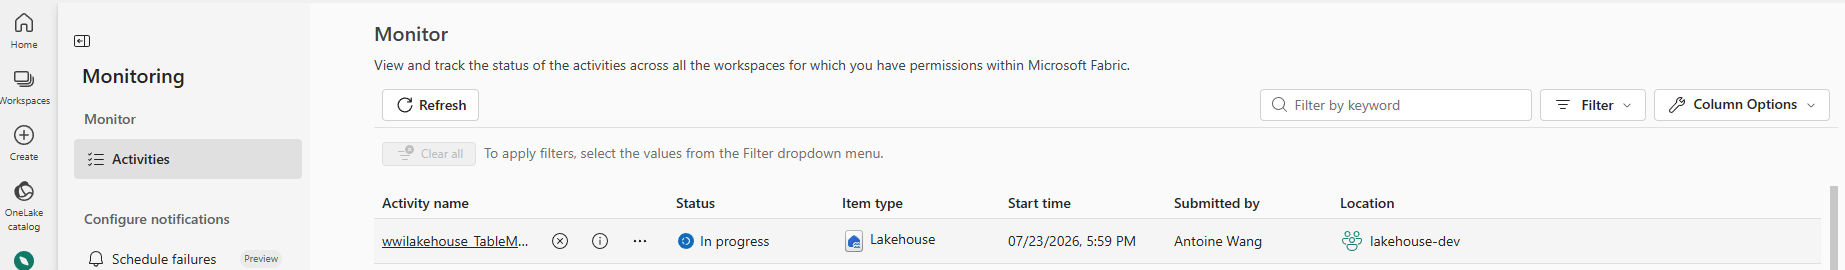
Vous suivez l’exécution dans le panneau Notifications (icône cloche en haut du portail) ou dans le Monitoring hub (colonne de gauche → Monitor). Les activités portail-initiées apparaissent sous le nom TableMaintenance.
Les 4 leviers en un coup d’œil
Reprenons les 4 commandes avec un focus “à quoi ça sert” et “quand l’utiliser”.
1) OPTIMIZE : la commande la plus rentable
OPTIMIZE prend tous les petits fichiers Parquet accumulés par vos ingestions et les réécrit en fichiers plus gros. Un scan qui lisait 5 000 fichiers en lit 50 après compaction. Les moteurs (Spark, SQL Analytics Endpoint, Warehouse, Direct Lake) apprécient tous les fichiers de taille homogène, c’est ce qui différencie un Lakehouse qui vieillit bien d’un autre qui suffoque.
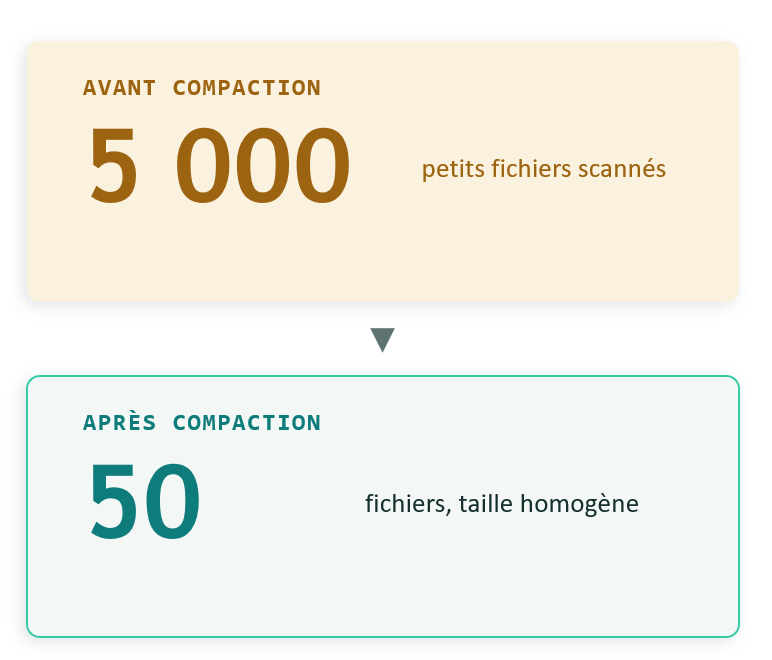
Quand la lancer : après une ingestion batch massive, ou dès que vous voyez le nombre de fichiers grimper (au-delà de 500 fichiers dans une partition qui devrait en contenir 20, c’est overdue). Sur les tables Gold servant Direct Lake, une fois par semaine hors heures ouvrées est un bon rythme.
2) V-Order : le boost lecture pour Direct Lake
V-Order est une optimisation d’écriture propriétaire Fabric. Elle réorganise les Parquet (row-group distribution, encoding, compression) pour améliorer la lecture. Ce n’est pas une commande à part entière, c’est un modificateur que vous cochez pendant l’OPTIMIZE (case “Apply V-Order” dans la boîte de dialogue).
⚠️ Depuis 2024, V-Order est désactivé par défaut sur les nouveaux workspaces Fabric. C’est un choix documenté par Microsoft — le gain n’est pas universel. Ne présumez pas qu’il tourne.
Quand l’utiliser : sur toutes vos tables Gold consommées par Power BI Direct Lake. Sur les tables Silver / Warehouse en lecture-intensive.
3) Z-Order : le levier ciblé et optionnel
Z-Order est un algorithme de co-localisation. Il place les lignes qui partagent des valeurs proches (typiquement date + customer_id, ou region + product_family) dans les mêmes fichiers Parquet. Le moteur peut ensuite sauter des fichiers entiers grâce aux statistiques min/max, c’est du data-skipping.
Z-Order est le levier le plus mal utilisé de Delta Lake. Il n’a de sens que si :
Vos requêtes filtrent régulièrement sur 2 colonnes ou plus ensemble.
Ces prédicats sont sélectifs (un filtre qui divise le volume par 20 ou 100, pas par 1,2).
Sinon, Z-Order coûte plus qu’il ne rapporte, chaque ZORDER BY réécrit tous les fichiers scopés, c’est un job cher.
Mon conseil : par défaut, pas de Z-Order. Vous l’ajoutez uniquement quand une requête spécifique mérite le data-skipping.
4) VACUUM : le nettoyage qui reprend du storage
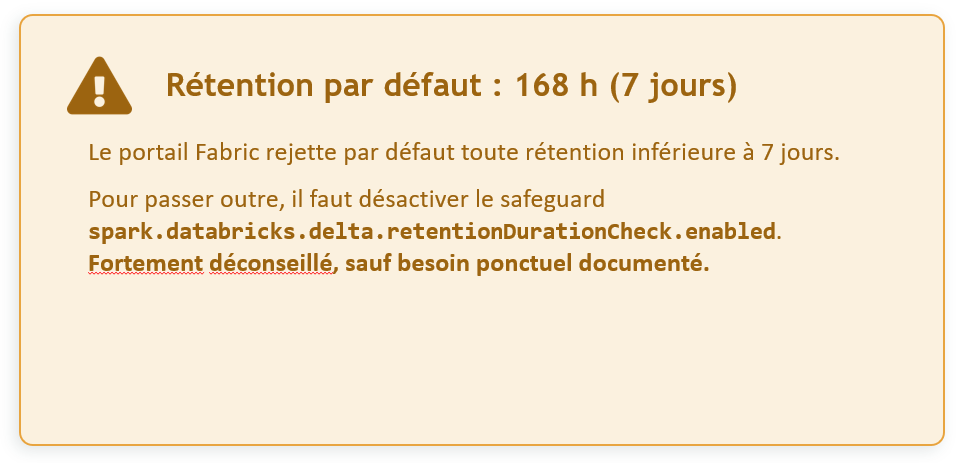
VACUUM supprime physiquement de OneLake les fichiers Parquet qui ne sont plus référencés par le Delta log ET qui sont plus vieux que la rétention. C’est ce qui reprend concrètement le storage après un OPTIMIZE, une série d’UPDATE / DELETE / MERGE, ou un INSERT OVERWRITE.
Trois choses que VACUUM ne fait pas :
Il ne supprime pas les fichiers du
_delta_log(rétention gérée séparément pardelta.logRetentionDuration, 30 jours par défaut).Il ne supprime pas les fichiers référencés par un deletion vector.
Il n’améliore pas les performances de lecture, sa mission, c’est le storage.
Quand le lancer : chaque semaine, en cadence hebdomadaire, après un OPTIMIZE. Rétention par défaut 7 jours. Ne descendez pas plus bas sans diagnostic préalable via DESCRIBE HISTORY.
Comment orchestrer la maintenance (sans code) ?
Le clic droit dans l’UI est parfait pour du ponctuel. Pour de la production, vous voulez l’automatiser. Fabric Data Factory expose une activité dédiée : la Lakehouse Maintenance activity.
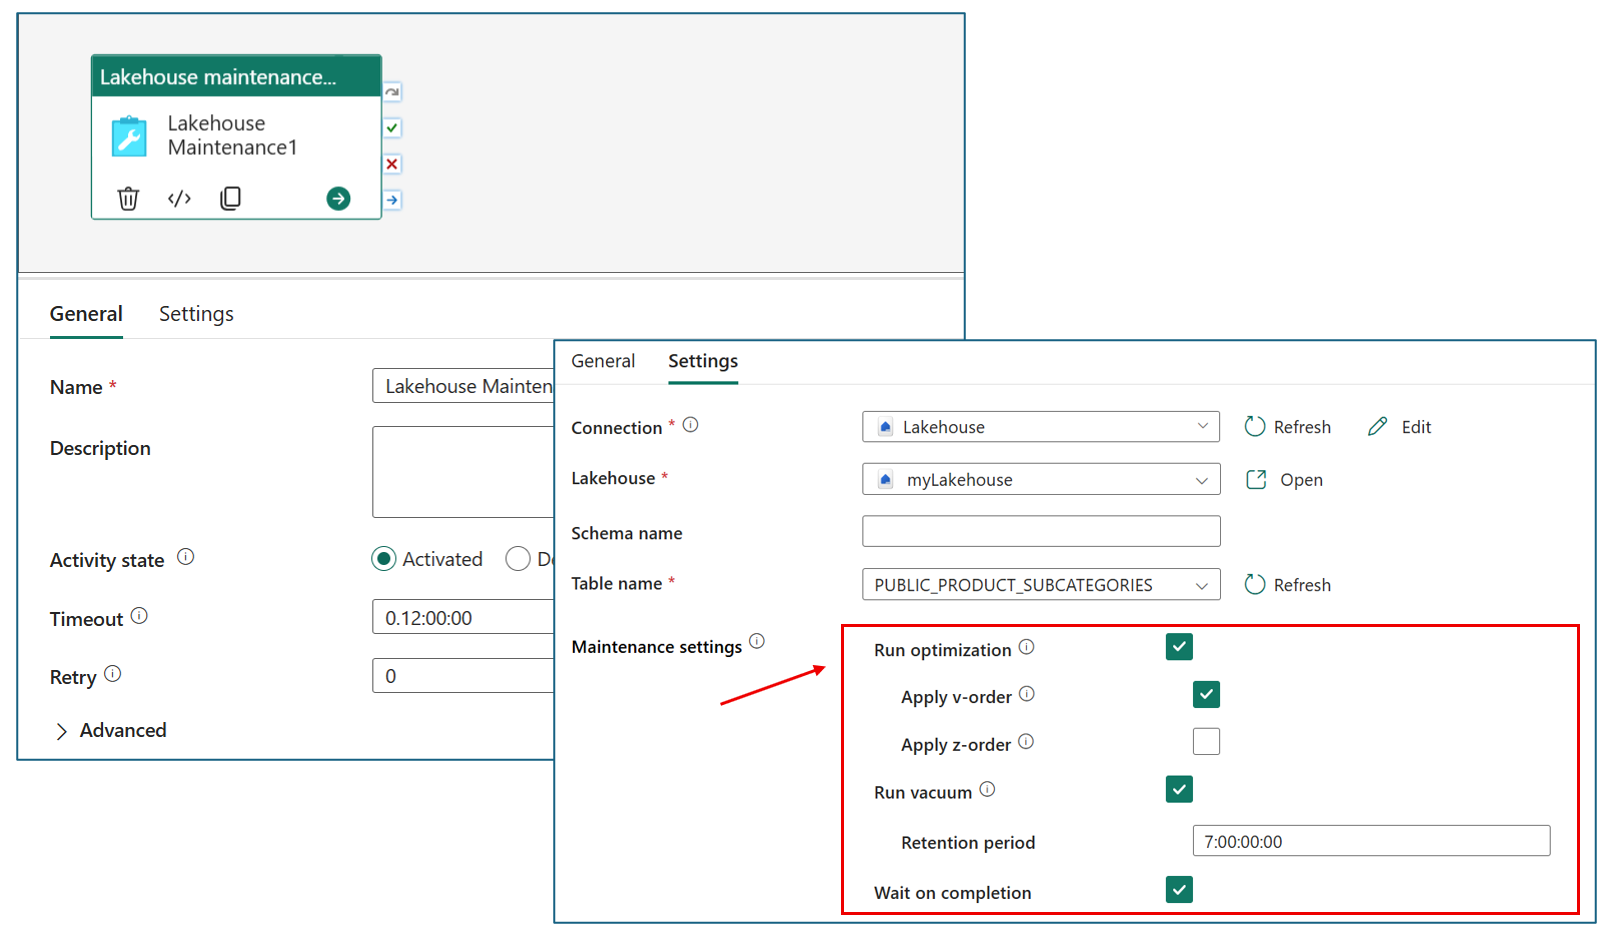
Cette activité expose exactement les mêmes options que l’UI (OPTIMIZE avec V-Order optionnel, VACUUM) et s’intègre dans un Pipeline avec dépendances, déclencheurs et paramètres. Le workflow typique :
Copy activity (ingestion vers Bronze).
Notebook activity (transformations Bronze → Silver → Gold).
Lakehouse Maintenance activity (
OPTIMIZE VORDERsur les tables Gold).Refresh SQL Endpoint activity (synchronise les métadonnées SQL en aval).
Lakehouse Maintenance activity (
VACUUM— après le framing des modèles sémantiques Direct Lake, jamais avant).
⚠️ Deux limitations à connaître sur la Lakehouse Maintenance activity (Preview) :
Elle ne s’exécute pas dans les workspaces avec Private Link activé.
🥇 La Règle d’Or
Si tu dois retenir une chose : la maintenance Delta Lake sur Fabric commence par le clic droit dans Lakehouse Explorer. Pas par du code. Pas par un Pipeline. Quatre commandes, OPTIMIZE, V-Order, Z-Order, VACUUM, chacune un usage précis, et une UI qui te les expose en trois clics. Tu maîtrises l’UI d’abord, tu automatises ensuite.
Et vous, avez-vous déjà lancé OPTIMIZE + V-Order sur vos tables Gold, ou est-ce encore du terrain vierge dans votre Lakehouse ? Répondez simplement à cet email ou ce post, je lis tous vos messages.
À la semaine prochaine pour continuer à explorer ensemble les entrailles de Fabric !
🔗 À lire dans Fabric Mastery
Architecture Médaillon Microsoft Fabric : Bronze, Silver, Gold
Microsoft Fabric : Comprendre OneLake, le "OneDrive" de la Data
📚 Ressources pour aller plus loin
Pour approfondir le sujet, je vous recommande ces lectures essentielles issues de la documentation officielle :
Run Delta table maintenance in Lakehouse, le point d’entrée officiel : boîte de dialogue Maintenance, options, retention, monitoring.
Delta table maintenance in Microsoft Fabric (concepts), OPTIMIZE, VACUUM, REORG, cadence recommandée,
DESCRIBE DETAIL/HISTORY.Lakehouse Maintenance activity (Preview), l’activité Data Factory pour orchestrer OPTIMIZE / VACUUM dans un Pipeline.
Optimize Delta Lake tables with V-Order, où V-Order aide (Direct Lake, Warehouse), où il pénalise (Spark seul), et comment le contrôler.
Refresh SQL Endpoint activity, pour chaîner la maintenance avec la synchronisation SQL analytics endpoint.